printfで日本語を出したら、縺薙s縺ォ縺。縺ッのような文字が並びました。直し方を調べると、「UTF-8にする」「BOMを付ける」「/utf-8を付ける」と、答えがバラバラに出てきます。
バラバラに見えるのは、それぞれが、文字コードの別の段階を変えているからです。そこで、ソースの文字コード(3種類)×コンパイルオプション(2種類)の6通りを全部ビルドして、実行時の文字列が実際にどんなバイト列になるかを測りました。バイト列まで見ると、どれが何を変えているのかが、はっきり分かります。ビルド時に出るC4819という警告も、あわせて整理しています。
検証は、Visual Studio 2022付属のMSVC(19.44、x64)をclコマンドで動かしました。Windowsは日本語環境(システムのコードページは932)です。
文字化けとは?
文字化けとは、
・文字を書き込んだ側と、読み取った側で、文字コードの取り決めが食い違っているために、別の文字に見えてしまう現象
です。日本語をprintfで出す場合、食い違いが起きる場所は3か所あります。
- ソースファイルの保存形式:エディタが、日本語をどんなバイト列でファイルに書いたか
- コンパイラが、文字列リテラルを、どんなバイト列にして実行ファイルに入れるか:ソースの読み方と、実行時の文字コード(実行文字セット)の2つで決まる
- コンソールが、受け取ったバイト列を、何の文字コードとして表示するか:Windowsのコマンドプロンプトは、既定でCP932(Shift_JIS)
どれか1か所でも食い違うと、化けます。だから「UTF-8にした」だけでは直らないことがあるのです。
実験:6通りを全部ビルドして、バイト列を見る
試した文字列は「こんにちは、世界」の8文字です。実行時に、文字列をそのまま出力して、さらに1バイトずつ16進数でも出力します。これで、コンパイラが実際に何を実行ファイルに入れたかが分かります。
▼main.cpp(これを、保存形式を変えて6通りビルドした)
#include <cstdio>
#include <cstring>

int main() {
    const char* s = "こんにちは、世界";
    std::printf("%s\n", s);
    for (size_t i = 0; i < std::strlen(s); i++) {
        std::printf("%02X ", (unsigned char)s[i]);
    }
    std::printf("\n");
    return 0;
}保存形式は、UTF-8(BOMなし)・UTF-8(BOMあり)・Shift_JIS(CP932)の3種類、コンパイルオプションは「指定なし」と/utf-8の2種類です。コンソールの表示は、出力されたバイト列を、CP932と UTF-8(65001)のそれぞれとして読み直して再現しました。
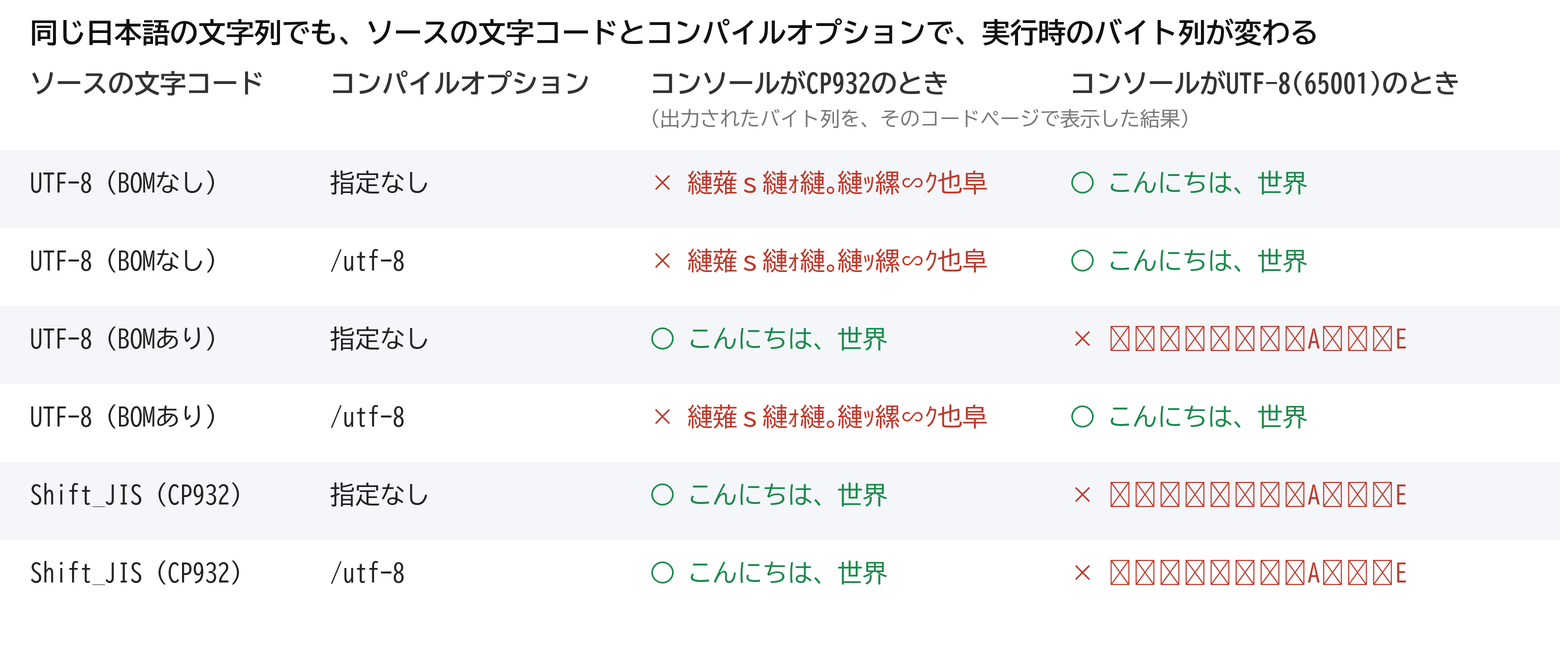
そのときの、実行時のバイト列です。
| ソースの保存形式 | オプション | 実行時のバイト列(先頭6バイト) | 全体の長さ |
|---|---|---|---|
| UTF-8(BOMなし) | 指定なし | E3 81 93 E3 82 93 … | 24 バイト |
| UTF-8(BOMなし) | /utf-8 | E3 81 93 E3 82 93 … | 24 バイト |
| UTF-8(BOMあり) | 指定なし | 82 B1 82 F1 82 C9 … | 16 バイト |
| UTF-8(BOMあり) | /utf-8 | E3 81 93 E3 82 93 … | 24 バイト |
| Shift_JIS(CP932) | 指定なし | 82 B1 82 F1 82 C9 … | 16 バイト |
| Shift_JIS(CP932) | /utf-8 | 82 B1 82 F1 82 C9 … | 16 バイト |
読み解く:何が何を変えているのか
表から、次のことが読み取れます。
- BOMなしUTF-8は、オプションなしでも
/utf-8でも、バイト列がUTF-8のまま(E3 81 93 …)。つまり、MSVCは「BOMなしだと、システムのコードページ(932)で読む」ため、UTF-8の文字をCP932として解釈しますが、それをそのまま実行ファイルに通していて、結果的にUTF-8のバイト列が残ります - BOMありUTF-8は、オプションなしだとCP932に変換される(82 B1 …、16バイト)。BOMがあるので、MSVCはUTF-8だと分かって正しく読み、実行文字セットのCP932に変換します
- Shift_JISは、オプションなしならCP932のまま(82 B1 …)。ところが
/utf-8を付けると、UTF-8として読めない文字があるという警告C4828が、日本語の文字のたびに出ます(今回は9件)。バイト列自体は変わりませんでした /utf-8を付けると、読み方と実行文字セットが両方UTF-8になる。BOMの有無に関係なく、バイト列がUTF-8にそろいます
main.cpp
main.cpp(1): warning C4828: オフセット 0x4c から始まる、現在のソースの文字セット (コードページ 65001) では使用できない文字がファイルに含まれています。
main.cpp(1): warning C4828: オフセット 0x4d から始まる、現在のソースの文字セット (コードページ 65001) では使用できない文字がファイルに含まれています。
main.cpp(1): warning C4828: オフセット 0x4e から始まる、現在のソースの文字セット (コードページ 65001) では使用できない文字がファイルに含まれています。
(同じ警告が、日本語の文字ごとに続く。全部で9件)ここで大事なのは、バイト列が決まれば、あとはコンソールの設定の問題ということです。UTF-8のバイト列(E3 81 93 …)は、UTF-8に設定したコンソールでしか、正しく表示されません。CP932のコンソール(コマンドプロンプトの既定)では、縺薙s縺ォ縺。縺ッのような、よく見る化け方になります。
【重要】罠:絵文字が、警告C4819のあとで壊れる
実は、ここまでの「BOMなしUTF-8 + オプションなし」は、文字によってはデータ自体が壊れます。CP932で表せない文字(絵文字など)を含むUTF-8のソースを、オプションなしでビルドしてみました。
▼main.cpp(絵文字を含む。UTF-8、BOMなし)
#include <cstdio>
#include <cstring>

// 敵が倒れた時の演出メモ 😀
int main() {
    const char* s = "クリア😀";
    std::printf("%s\n", s);
    for (size_t i = 0; i < std::strlen(s); i++) {
        std::printf("%02X ", (unsigned char)s[i]);
    }
    std::printf("\n");
    return 0;
}
main.cpp
main.cpp(1): warning C4819: ファイルは、現在のコード ページ (932) で表示できない文字を含んでいます。データの損失を防ぐために、ファイルを Unicode 形式で保存してください。hex : E3 82 AF E3 83 AA E3 82 A2 F0 9F 81 45警告C4819は、「現在のコードページ(932)で表示できない文字を含んでいます。データの損失を防ぐために、Unicode形式で保存してください」という意味です。「データの損失」と書いてあるとおり、本当に壊れました。「クリア😀」のバイト列を見ると、
正しいUTF-8 の 😀   : F0 9F 98 80
実際に入っていた値      : F0 9F 81 45
98 80のところが81 45に変わっています。UTF-8として読み直しても、もう絵文字には戻りません。/utf-8を付けて同じソースをビルドすると、バイト列はF0 9F 98 80のまま壊れませんでした。
hex : E3 82 AF E3 83 AA E3 82 A2 F0 9F 98 80この警告は、私の手元のDirectXのプロジェクトのビルドでも出ていました(ヘッダーの1行目に付く警告で、ファイルにCP932で表せない文字があるという意味です)。「警告だから」と放置しがちですが、C4819は、文字が実際に化ける前触れです。ファイルの中に、コメントだけであっても、絵文字や機種依存の記号があると出ます。
どれを選べばいいのか
実験の結果から、組み合わせを整理します。
| やりたいこと | 推すやり方 | 理由(今回の実測から) |
|---|---|---|
| 新しくプロジェクトを作る | ソースはUTF-8、オプションは/utf-8、コンソールもUTF-8 | BOMの有無に関係なくバイト列がUTF-8にそろう。絵文字も壊れない |
| 昔のShift_JISのソースが大量にある | Shift_JISのまま、/utf-8は付けない | /utf-8を付けるとC4828の警告が大量に出る。CP932コンソールで正しく読める |
| UTF-8とShift_JISのファイルが混ざっている | どちらかに統一してからビルドする | 同じオプションで、ファイルごとに結果が変わる(上の表) |
なお、コンソールをUTF-8にするには、コマンドプロンプトでchcp 65001を実行するか、プログラムの先頭でSetConsoleOutputCP(CP_UTF8)を呼びます。今回は、コンソールの表示を「バイト列を、各コードページで読み直して再現」したので、この呼び出し自体は実行していません。
文字化けのよくある失敗例と対処法
①UTF-8で保存したのに、printfが化ける
BOMなしのUTF-8で保存して、オプションなしでビルドすると、バイト列はUTF-8になります。それをCP932のコンソールで見れば、化けて当然です。コンソールをUTF-8にするか、ソースをShift_JISに戻すか、バイト列とコンソールをそろえるのが対処です。
②BOMを付けたら直ったので、そのままにする
BOMありのUTF-8は、オプションなしだとCP932に変換されるので、CP932のコンソールでは正しく読めます。ただし、同じ絵文字入りのソースにBOMを付けてビルドすると、別の警告C4566が出て、絵文字は?に置き換わりました。
main.cpp
main.cpp(6): warning C4566: ユニバーサル文字名 '\U0001F600' によって表示されている文字は、現在のコード ページ (932) で表示できません
hex : 83 4E 83 8A 83 41 3F 3Fバイト列は83 4E 83 8A 83 41 3F 3Fで、最後の4バイトの絵文字は、3F 3F(??)になっています。文字化けが直ったように見えても、絵文字や機種依存文字を入れた途端に壊れます。
③C4819を無視する
絵文字が壊れた実験のとおり、C4819は、データの損失の警告です。警告が出たファイルは、UTF-8で保存し直して、/utf-8を付けます。
④エディタの画面で、日本語が化けて見える
これは、実行時の文字化けとは別の問題で、ファイルを開くときの文字コードの読み間違いです。私のプロジェクトでも、.cppはShift_JISのまま使っているので、UTF-8として書き込むツールで編集すると、ファイル内の日本語のコメントが壊れました。ファイルの文字コードと、編集ツールの書き込み形式をそろえることが、予防になります。
注意点
- 文字化けは、「ソース」「実行時のバイト列」「コンソール」の3か所の食い違いで起きる
- MSVCは、BOMなしのファイルを、システムのコードページ(日本語環境なら932)として読む
/utf-8を付けると、読み方と実行文字セットが両方UTF-8になる- C4819は、データの損失の警告。絵文字などが、本当に壊れる
- Shift_JISのソースに
/utf-8を付けると、C4828の警告が大量に出る - 今回の検証は、MSVC 19.44(日本語環境)のもの。他のコンパイラ、他のOSの設定では結果が変わりうる
結論
- 6通り(保存形式3×オプション2)で、実行時のバイト列を実測した。BOMなしUTF-8はバイト列がUTF-8、BOMありUTF-8とShift_JISは、オプションなしならCP932
/utf-8を付けると、バイト列がUTF-8にそろう。あとはコンソールをUTF-8にすればよい- C4819は、データの損失。絵文字が
F0 9F 98 80からF0 9F 81 45に壊れた - 新規ならUTF-8 +
/utf-8、既存のShift_JISならそのまま、混在は避ける
文字化けは、「どの文字コードにするか」ではなく、「3か所をそろえる」問題でした。バイト列を16進数で出してみると、どこで食い違っているのかが一目で分かります。迷ったら、まず1バイトずつ出してみるのが近道です。