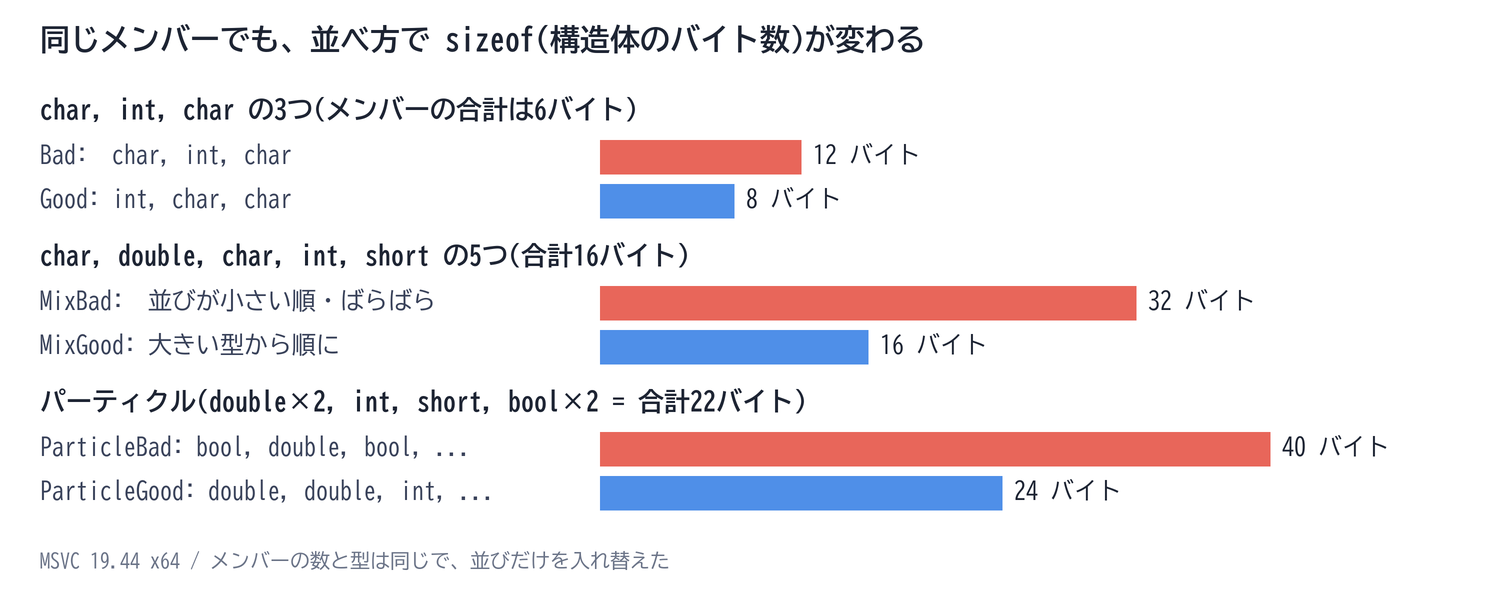
charが2つとintが1つの構造体は、メンバーを足すと、1 + 4 + 1 = 6バイトです。ところが、sizeofで測ると、12バイトと出ます。ちょうど倍です。メンバーの並びを入れ替えるだけで、この12は、8に変わります。
増えた分は、パディング(隙間)と呼ばれる、使われないバイトです。実際に、並べ方を変えて、sizeofとメモリ使用量、速さがどう変わるかを測りました。パディングの中身が、思わぬ形で顔を出す場面も、確かめています。
検証は、Visual Studio 2022付属のMSVC(19.44、x64)を、Release(/O2 /MD、警告は/W4)で動かして行いました。
構造体のパディングとは?
・構造体のメンバーを、型ごとに決まった境界(アライメント)に合わせて置くために、メンバーの間や、末尾に入れる、使われないバイト
CPUは、int(4バイト)なら4の倍数、double(8バイト)なら8の倍数の位置に、置いてあるほうが、効率よく読めます。そのため、コンパイラは、その位置にメンバーが来るように、手前に隙間を入れます。さらに、構造体全体の大きさも、最も大きいメンバーのアライメントの倍数になるよう、末尾に隙間を足します。
実験①:メンバーの並びを入れ替える
同じメンバーで、並びだけが違う構造体を2組作り、sizeofと、各メンバーの位置(offsetof)を表示しました。
▼e1_layout.cpp
// 構造体のメンバーの並べ方で、sizeof がどう変わるか
#include <cstddef>
#include <cstdio>

struct Bad    { char a; int b; char c; };
struct Good   { int b; char a; char c; };

struct MixBad  { char a; double d; char b; int i; short s; };
struct MixGood { double d; int i; short s; char a; char b; };

#define SHOW3(T, m1, m2, m3, memberBytes) \
    std::printf("%-8s sizeof = %2zu  | %s@%zu  %s@%zu  %s@%zu | メンバーの合計 %d バイト → パディング %zu バイト\n", \
        #T, sizeof(T), #m1, offsetof(T, m1), #m2, offsetof(T, m2), #m3, offsetof(T, m3), memberBytes, sizeof(T) - (memberBytes))

int main()
{
    SHOW3(Bad,  a, b, c, 6);
    SHOW3(Good, b, a, c, 6);

    std::printf("\n");
    std::printf("MixBad   sizeof = %2zu  | a@%zu d@%zu b@%zu i@%zu s@%zu | メンバーの合計 %d バイト → パディング %zu バイト\n",
        sizeof(MixBad), offsetof(MixBad, a), offsetof(MixBad, d), offsetof(MixBad, b), offsetof(MixBad, i), offsetof(MixBad, s), 1 + 8 + 1 + 4 + 2, sizeof(MixBad) - 16);
    std::printf("MixGood  sizeof = %2zu  | d@%zu i@%zu s@%zu a@%zu b@%zu | メンバーの合計 %d バイト → パディング %zu バイト\n",
        sizeof(MixGood), offsetof(MixGood, d), offsetof(MixGood, i), offsetof(MixGood, s), offsetof(MixGood, a), offsetof(MixGood, b), 8 + 4 + 2 + 1 + 1, sizeof(MixGood) - 16);
    std::printf("\nalignof(Bad) = %zu, alignof(MixBad) = %zu (構造体の大きさは、これの倍数になる)\n", alignof(Bad), alignof(MixBad));
    return 0;
}
Bad sizeof = 12 | a@0 b@4 c@8 | メンバーの合計 6 バイト → パディング 6 バイト
Good sizeof = 8 | b@0 a@4 c@5 | メンバーの合計 6 バイト → パディング 2 バイト
MixBad sizeof = 32 | a@0 d@8 b@16 i@20 s@24 | メンバーの合計 16 バイト → パディング 16 バイト
MixGood sizeof = 16 | d@0 i@8 s@12 a@14 b@15 | メンバーの合計 16 バイト → パディング 0 バイト
alignof(Bad) = 4, alignof(MixBad) = 8 (構造体の大きさは、これの倍数になる)Bad(char・int・char)は、aが0番、bが4番、cが8番にあり、sizeofは12でした。aのあとの、3バイトと、cのあとの3バイトが、パディング(合計6バイト)です。intが先のGoodにすると、sizeofは8で、パディングは、末尾の2バイトだけになりました。
メンバーが増えると、差も大きくなります。char・double・char・int・shortの並びのMixBadは、sizeofが32で、メンバーの合計16バイトの、ちょうど倍でした。大きい型から順に並べたMixGoodは、sizeofが16で、パディングは0バイトです。
実験②:パーティクル500万個で、メモリと速さを比べる
ゲームで使いそうな、パーティクルの構造体で、並びの違いを比べます。boolとdoubleが、交互に並ぶ書き方(ParticleBad)と、大きい型から順に並べた書き方(ParticleGood)です。500万個の配列を、4回なめて、座標を更新します。
▼e2_particles.cpp
// パーティクルの構造体を、メンバーの並びだけ変えて、メモリと速さを比べる
#include <chrono>
#include <cstdio>
#include <vector>

struct ParticleBad
{
    bool   alive;
    double x;
    bool   visible;
    double y;
    int    id;
    short  life;
};

struct ParticleGood
{
    double x;
    double y;
    int    id;
    short  life;
    bool   alive;
    bool   visible;
};

static volatile double g_sink = 0;

template <class P> double run(int n, const char* label)
{
    std::vector<P> v(n);
    for (int i = 0; i < n; ++i) { v[i].alive = (i % 3) != 0; v[i].x = i; v[i].y = i * 2.0; v[i].id = i; v[i].life = 1; v[i].visible = true; }
    double best = 1e30;
    for (int rep = 0; rep < 7; ++rep)
    {
        auto t0 = std::chrono::steady_clock::now();
        double s = 0;
        for (int k = 0; k < 4; ++k)
            for (int i = 0; i < n; ++i)
                if (v[i].alive) { v[i].x += 1.0; s += v[i].y; }
        auto t1 = std::chrono::steady_clock::now();
        g_sink = s;
        double ms = std::chrono::duration<double, std::milli>(t1 - t0).count();
        if (ms < best) best = ms;
    }
    std::printf("%-13s sizeof = %2zu バイト / %d 個で %6.1f MB / 4回なめる時間 %6.1f ms\n", label, sizeof(P), n, sizeof(P) * (double)n / (1024.0 * 1024.0), best);
    return best;
}

int main()
{
    const int n = 5000000;
    double a = run<ParticleBad>(n, "ParticleBad");
    double b = run<ParticleGood>(n, "ParticleGood");
    std::printf("並べ替えたほうは、時間が %.2f 倍\n", a / b);
    return 0;
}
ParticleBad sizeof = 40 バイト / 5000000 個で 190.7 MB / 4回なめる時間 69.9 ms
ParticleGood sizeof = 24 バイト / 5000000 個で 114.4 MB / 4回なめる時間 45.1 ms
並べ替えたほうは、時間が 1.55 倍| sizeof | 500万個のメモリ | 4回なめる時間 | |
|---|---|---|---|
ParticleBad(boolとdoubleが交互) | 40バイト | 190.7 MB | 69.9 ms |
ParticleGood(大きい型から順) | 24バイト | 114.4 MB | 45.1 ms |
並べ替えただけで、メモリは190.7MBから114.4MBへ、約40%減りました。時間も、69.9ミリ秒から45.1ミリ秒になり、約1.55倍速くなっています。1個あたりの大きさが小さいほど、CPUのキャッシュ(高速な一時置き場)に、多くの要素が収まり、メモリから読み込む量も減るためです。
実験③:#pragma pack(1)で、隙間を詰める
並べ替えが、使えないとき(ファイルの形式や、外部との取り決めで、並びが固定されている)には、#pragma pack(1)で、隙間を詰める方法もあります。同じchar・int・charの構造体を、詰めた版(Packed)と、詰めない版(Normal)で、比べました。
▼e3_pack.cpp
// #pragma pack(1) で隙間を詰める。サイズは減るが、速さは?
#include <chrono>
#include <cstdio>
#include <vector>

struct Normal { char a; int b; char c; };

#pragma pack(push, 1)
struct Packed { char a; int b; char c; };
#pragma pack(pop)

static volatile long long g_sink = 0;

template <class T> void run(const char* label)
{
    const int n = 10000000;
    std::vector<T> v(n);
    for (int i = 0; i < n; ++i) { v[i].a = 1; v[i].b = i; v[i].c = 2; }
    double best = 1e30;
    for (int rep = 0; rep < 7; ++rep)
    {
        auto t0 = std::chrono::steady_clock::now();
        long long s = 0;
        for (int k = 0; k < 4; ++k)
            for (int i = 0; i < n; ++i) s += v[i].b + v[i].a;
        auto t1 = std::chrono::steady_clock::now();
        g_sink = s;
        double ms = std::chrono::duration<double, std::milli>(t1 - t0).count();
        if (ms < best) best = ms;
    }
    std::printf("%-8s sizeof = %2zu バイト / %d 個で %5.1f MB / 4回なめる時間 %6.1f ms\n", label, sizeof(T), n, sizeof(T) * (double)n / (1024.0 * 1024.0), best);
}

int main()
{
    run<Normal>("Normal");
    run<Packed>("Packed");
    return 0;
}
Normal sizeof = 12 バイト / 10000000 個で 114.4 MB / 4回なめる時間 30.6 ms
Packed sizeof = 6 バイト / 10000000 個で 57.2 MB / 4回なめる時間 16.6 mssizeofは12から6になり、メモリも半分でした。時間は、30.6ミリ秒から16.6ミリ秒で、この環境では、詰めたほうが速くなりました。読み込む量が、半分になったためとみられます。
ただし、詰めた構造体では、intが、4の倍数でない位置に置かれます。x64のこの環境では、そのまま読めましたが、ずれた位置の読み込みを、許さないCPUもあります。また、詰めた構造体のメンバーの、ポインタや参照を取ると、問題が出る場合があります。今回は、これらを検証していないので、他の環境での動きは、確かめていません。まず、並べ替えを試して、詰めるのは、そのあとにするほうが、安全です。
【重要】実験④:パディングの中身は、決まっていない
パディングは、「使われない」バイトですが、「ゼロ」とは、限りません。メンバーの値が、まったく同じ2つの構造体を作り、わざと、メモリの残りカスを、別の値(0xCDと0xAB)にしておいて、比べました。
▼e4_bytes.cpp
// パディングの中身は、決まっていない。メンバーが同じでも、バイト列は違うことがある
#include <cstdio>
#include <cstring>
#include <new>
#include <type_traits>

struct Bad { char a; int b; char c; };         // 12バイト(パディングあり)
struct Tight { int x; int y; };                // 8バイト(パディングなし)

static void dump(const char* label, const void* p, size_t n)
{
    std::printf("%-22s", label);
    const unsigned char* b = (const unsigned char*)p;
    for (size_t i = 0; i < n; ++i) std::printf("%02X ", b[i]);
    std::printf("\n");
}

int main()
{
    // 「メモリの残りカス」を、わざと違う値にしてから、同じメンバーの値を入れる
    alignas(Bad) unsigned char buf1[sizeof(Bad)];
    alignas(Bad) unsigned char buf2[sizeof(Bad)];
    std::memset(buf1, 0xCD, sizeof buf1);
    std::memset(buf2, 0xAB, sizeof buf2);
    Bad* p = new (buf1) Bad;
    Bad* q = new (buf2) Bad;
    p->a = 'x'; p->b = 0x12345678; p->c = 'y';
    q->a = 'x'; q->b = 0x12345678; q->c = 'y';

    dump("p のバイト列:", p, sizeof(Bad));
    dump("q のバイト列:", q, sizeof(Bad));
    bool memberEq = p->a == q->a && p->b == q->b && p->c == q->c;
    std::printf("メンバーを1つずつ比べると : %s\n", memberEq ? "同じ" : "違う");
    std::printf("memcmp で比べると        : %s\n", std::memcmp(p, q, sizeof(Bad)) == 0 ? "同じ" : "違う");

    std::printf("\nstd::has_unique_object_representations_v<Bad>   = %s\n", std::has_unique_object_representations_v<Bad> ? "true" : "false");
    std::printf("std::has_unique_object_representations_v<Tight> = %s\n", std::has_unique_object_representations_v<Tight> ? "true" : "false");
    return 0;
}
p のバイト列: 78 CD CD CD 78 56 34 12 79 CD CD CD
q のバイト列: 78 AB AB AB 78 56 34 12 79 AB AB AB
メンバーを1つずつ比べると : 同じ
memcmp で比べると : 違う
std::has_unique_object_representations_v<Bad> = false
std::has_unique_object_representations_v<Tight> = trueメンバーを1つずつ比べると、同じです。ところが、memcmpで、構造体の中身を丸ごと比べると、違うという結果でした。バイト列を見ると、パディングの位置(先頭の78(文字x)と、末尾の79(文字y)の、あとの3バイトずつ)に、CDとABが残っています。
std::has_unique_object_representations_vで調べると、パディングのあるBadはfalse、ないTightはtrueでした。falseの構造体では、「メンバーが等しい」と、「バイト列が等しい」が、一致しません。
この違いは、次のような場面で、バグになります。
memcmpで、構造体どうしの等しさを判定する(同じ値なのに、「違う」と判定される)- 構造体のバイト列を、ハッシュ(
std::hashの自作など)の入力にする(同じ値なのに、ハッシュが違う) - 構造体を、
fwriteで、そのままファイルに保存する(ファイルの内容が、毎回違う。メモリの残りカスが、ファイルに混ざる)
メンバーを1つずつ比べる(または、1つずつ書き出す)ようにするか、パディングのない構造体にするのが、確実です。ファイルに構造体を保存する場面は、アセットのバイナリベイクの記事でも、扱っています。
並べ方の基本ルール
- 大きいアライメントの型から、順に並べる(
double・int64_t・ポインタ →int・float→short→char・bool) - 同じサイズの型は、まとめる(
boolを、バラバラに置かず、末尾にまとめる) - 並べ替えたら、
sizeofとstatic_assertで、サイズを確かめる
▼並べ方の例
struct Particle
{
    double x;       // 8バイト
    double y;       // 8バイト
    int    id;      // 4バイト
    short  life;    // 2バイト
    bool   alive;   // 1バイト
    bool   visible; // 1バイト
};
static_assert(sizeof(Particle) == 24, "Particle のサイズが変わった(パディングが増えていないか確認)");static_assertを書いておくと、あとからメンバーを足して、パディングが増えたときに、ビルドの段階で気づけます。
よくある失敗例と対処法
①メンバーを、意味のまとまりで並べて、パディングを気にしない
「名前、HP、座標」のように、意味で並べるのは、読みやすいです。ただ、大量に作る構造体(パーティクル、弾、敵)では、実験②のとおり、メモリと速さに、差が出ます。大量に作る型だけ、並びを見直します。
②sizeofを、メンバーの合計だと思い込む
バイナリの形式を決めるときや、外部のAPIにメモリを渡すときに、sizeofを使って、合計とずれて、事故になります。sizeofの記事も、あわせて見てください。
③memcmpで、構造体を比べる
実験④のとおり、パディングの中身が違うと、「違う」になります。operator==を、メンバーごとに書きます。
④GPUに渡す構造体の、サイズを、C++のsizeofで決める
GPU側(HLSL)のパッキングの規則は、C++とは異なります。float3が、C++では12バイト、HLSLでは16バイトの境界になる件は、定数バッファの記事で、実測しています。
注意点
sizeofは、メンバーの合計より大きくなることがある。増えた分が、パディング- 並びを入れ替えるだけで、
12→8、32→16、40→24になった - パーティクル500万個で、メモリが約40%減り、時間が約1.55倍速くなった
#pragma pack(1)は、sizeofが半分になり、この環境では速かったが、他の環境での動きは、確かめていない- パディングの中身は決まっていない。メンバーが同じでも、
memcmpでは「違う」になった - 今回の検証は、MSVC 19.44(Visual Studio 2022付属、x64、
/O2 /MD)で行った。アライメントの規則は、環境で異なる
この記事のポイント
- 構造体の
sizeofは、メンバーの合計とは限らない。隙間(パディング)が入る - 大量に作る構造体は、大きい型から順に並べる。それだけで、メモリも速さも、改善する
- パディングの中身は不定。
memcmp・ハッシュ・fwriteに、構造体を丸ごと渡さない - 並べ替えたら、
static_assert(sizeof(...))で、サイズを固定しておく
見えないバイトは、見えないぶん、気づきにくいものです。sizeofを一度、出力してみる。それだけで、構造体の中に入っている、使われていないバイトが、はっきり見えてきます。
あわせて読みたい
- 【C++】sizeofとは?|使い方・配列とポインタの違いを初心者向けに解説
- 【ゲーム制作】DirectX11の定数バッファの値がシェーダーでずれる原因とは?|16バイト境界(パッキング)をC++とHLSLで実測して比べる
- 【C++】構造体(struct)とクラス(class)の違いとは?|どっちを使えばいい?
- 【ゲーム制作】アセットのバイナリベイクとは?|ロードを速くする仕組みを初心者向けに解説
- 【C++】フライウェイトパターンとは?|大量の敵でメモリを節約する方法
- 【C++】初期化していない変数の値はどうなる?|Debugでは動くのにReleaseだけ挙動が変わる原因を、同じコードで3通り実測